RoPE 的基本思想与作用
RoPE(Rotary Position Embedding,旋转位置编码) 最早在 RoFormer: Enhanced Transformer with Rotary Position Embedding 中提出,用于在 Transformer 的注意力计算中引入位置信息。
其核心思想可以概括为:
根据 Token 的位置旋转其 Query 和 Key 向量,让旋转后的内积自然依赖两个 Token 的相对位置差。
在标准的 1D RoPE 中,如果 Query 位于位置 m、Key 位于位置 n,且原始内容向量分别为 qm,kn,那么:
qm=Rmqm,kn=Rnkn
qm⊤kn=qm⊤Rn−mkn
其中,Rm 表示由位置 m 确定的高维旋转算子。虽然 Query 和 Key 分别按照各自的绝对位置旋转,但在二者的点积中,位置相关项只取决于相对位移 n−m。这是 RoPE 的核心性质。
RoPE 的基本特点如下:
- 标准 RoPE 通常仅对 Q 和 K 施加旋转,不旋转 V;
- 旋转发生在各个 Attention Head 的特征空间内部,不涉及不同 Token 或不同 Head 之间的配对;
- 每两个特征维度组成一个二维旋转子空间,不同子空间使用不同的旋转频率;
- 标准 RoPE 不需要额外的可学习绝对位置表,但模型仍需在训练过程中学习如何使用这些位置关系。
无位置编码 Attention 的局限
Self-Attention 的内容匹配机制
设序列表示为 X∈RL×dmodel。标准 Self-Attention 首先通过线性投影获得:
Q=XWQ,K=XWK,V=XWV
Attention(Q,K,V)=Softmax(dkQK⊤)V
其中,Q 为查询向量,K 为键向量,V 为用于加权聚合的值向量。位置 m,n 对应的两个 Token,其原始注意力分数(logit)为:
sm,n=dkqm⊤kn
上述公式没有显式包含位置 m、n,也没有包含距离 ∣m−n∣。在 qm 与 kn 不变的条件下,即使二者从相邻位置移动到相距较远的位置,其未经 Softmax 归一化的 QK 点积仍保持不变。
因此,对于不使用位置编码的普通双向 Self-Attention,先后顺序与相对距离都不会直接进入 QK 匹配计算。
例如句子为:
模型不会仅凭该注意力结构识别“小猫在小狗之前”,也不会直接区分两者间隔 1 个还是 10 个 Token。
这一性质可以用**置换等变性(Permutation Equivariance)**描述:当模型不使用位置编码或位置相关 Mask 时,对于任意排列矩阵 P,有:
Attention(PX)=PAttention(X)
即输入 Token 的排列发生变化时,输出也会按照相同方式排列;注意力层本身不会额外引入绝对位置索引。
传统位置编码:绝对位置与相对位置
比较不同位置编码方法时,需要区分两个层面:位置信息的生成方式与位置信息的注入方式。
- 位置信息的生成方式(如何表示位置)
- 固定位置编码:通过预定义的数学公式生成,例如 Sinusoidal Position Encoding 和 RoPE,通常不需要学习额外的位置参数。
- 可学习位置编码:通过可训练的参数表示位置,例如 Learned Absolute Position Embedding、可学习的相对位置向量和相对位置偏置。
- 位置信息的注入方式(如何使用位置)
- 加性注入:将位置向量直接加到 Token Embedding 上,例如经典 Transformer 的正弦位置编码和 BERT 的可学习绝对位置编码。
- 注意力分数修正:在 Attention Score 中加入与相对位置相关的向量项或标量偏置,例如 Shaw Relative Position Encoding 和 T5 Relative Position Bias。
- 旋转变换:根据位置对 Query、Key 进行旋转,使其内积自然包含相对位移信息,例如 RoPE。
经典正弦/余弦绝对位置编码:固定生成,然后相加
原始 Transformer(Attention Is All You Need)采用固定的正弦、余弦位置编码,其定义为:
PE(m,2j)PE(m,2j+1)=sin(100002j/dm),=cos(100002j/dm).
其中,m 为序列位置,j 为频率组索引,d 为位置向量的维度。计算得到 PE(m) 后,将其与 Token Embedding 逐元素相加:
hm=xm+PE(m)
例如,当 Token Embedding 与位置向量均为 768 维时,相加后仍得到 768 维表示。正余弦位置编码不包含可训练的位置参数,而模型的其他参数可以学习利用所注入的位置信息。
可学习绝对位置嵌入:查表,然后相加
GPT-2、BERT 等模型采用过可学习的绝对位置嵌入。设位置嵌入矩阵为:
P∈RLmax×d
其中 Lmax 为最大位置数量。矩阵中的每一行对应一个可学习的位置向量。对于位置 m,取出对应的向量并与内容表示相加:
hm=xm+P[m]
当位置嵌入表仅覆盖 0 至 Lmax−1 时,超出该范围的位置无法直接查表,这是可学习绝对位置嵌入的一项实现限制。
RoPE 之前的相对位置编码方法
RoPE 并非最早使用相对位置的方案。此前已有相对位置 Attention 通过与位置差相关的向量或偏置调整注意力分数,例如:
sm,n=dkqm⊤(kn+rm−n)
或者直接加入相对偏置:
sm,n=dkqm⊤kn+bm−n
其中,rm−n 与 bm−n 均由相对位移决定,rm−n 和 bm−n 通常都是可学习参数,但它们的形式不同:
- rm−n:相对位置嵌入向量(Relative Position Embedding Vector)
- bm−n:相对位置偏置(Relative Position Bias),通常是一个标量
RoPE 的主要区别在于:通过旋转矩阵的代数性质,使相对位移自然出现在 Query 与 Key 的内积中。此外,经典正弦位置编码本身也包含可用于表达相对位移的数学结构,因此绝对位置编码并非完全无法表征距离关系。
Attention Head、Query 与特征维度
在讨论高维旋转之前,需要明确 Attention Head、特征向量及其各维度之间的关系。
Token、Attention Head 与特征维度
假设某个 Transformer 的隐藏层维度为:
dmodel=512
单个 Token 的隐藏状态可表示为 512 维向量:
x=[x0,x1,…,x511]
其中,xi 表示向量的第 i 个标量分量,而非独立的向量。若模型包含 8 个 Query Attention Head,每个 Head 的维度为 64,则:
8×64=512
标准多头注意力通常先通过可学习的 Q/K/V 线性投影,再将投影结果重排为多个 Head。这不同于直接把原始 Token Embedding 划分成若干段。
单个 Token 在其中一个 Head 上的 Query 向量可以写为:
q=[q0,q1,…,q63]
其中,q0、q1 等是标量分量,而 q 是完整的 64 维 Query 向量。
说明: GQA/MQA 等注意力结构可能采用不同数量的 Query Head 与 Key/Value Head。下文以普通多头注意力为例,不影响 RoPE 在单个 Head 内的旋转原理。
二维特征分组的原因
标准 RoPE 以二维旋转为基本运算,因此每次旋转需要两个标量坐标。以一个 8 维 Query 向量为例:
q=[q0,q1,q2,q3,q4,q5,q6,q7]
可以分成四个二维组:
(q0,q1), (q2,q3), (q4,q5), (q6,q7)
每组由同一个 Token、同一个 Head 内的两个标量维度构成一个二维特征子空间。此处的分组不是对 Token 或 Attention Head 进行分组,不同二维子空间分别对应不同的旋转频率。
二维旋转:RoPE 的几何基础
旋转矩阵
设一个二维列向量:
x=[x0x1]
对该向量施加逆时针方向、角度为 ϕ 的旋转:
R(ϕ)=[cosϕsinϕ−sinϕcosϕ],x′=R(ϕ)x
将矩阵乘法展开,可得:
x0′x1′=x0cosϕ−x1sinϕ=x0sinϕ+x1cosϕ
例如,当 x=(1,0) 时,旋转 90∘ 后得到 (0,1),旋转 180∘ 后得到 (−1,0)。
位置决定旋转角度
RoPE 将序列位置 m 映射为旋转角度:
ϕm=mθ
其中,θ 表示每增加一个位置所对应的旋转角增量,单位为弧度。例如,θ=π/6 时,位置 0、1、2、3 分别对应 0∘,30∘,60∘,90∘。实际模型会为不同二维子空间设置不同的 θj,后文将进一步说明。
二维旋转矩阵满足以下两个性质:
R(α)⊤=R(−α)
R(α)R(β)=R(α+β)
第一式表示转置对应反向旋转,第二式表示旋转角度的可加性。RoPE 的相对位置性质正是由这两个性质导出的。
核心推导:绝对位置旋转产生相对位置
设 qm 和 kn 分别为位置 m 和 n 上未经旋转的 Query、Key。先考虑单个二维子空间:
qm=R(mθ)qm,kn=R(nθ)kn
旋转后,两者的点积为:
qm⊤kn=(R(mθ)qm)⊤(R(nθ)kn)=qm⊤R(mθ)⊤R(nθ)kn=qm⊤R(−mθ)R(nθ)kn=qm⊤R((n−m)θ)kn
于是:
分别使用绝对位置R(mθ),R(nθ) ⟶ 内积中只剩相对位移R((n−m)θ)
需要区分的是:“仅依赖相对位置”所指的是点积中的位置相关旋转项,并不意味着注意力分数只由位置差确定。该分数仍由 qm 和 kn 的内容共同决定;最终注意力权重还受 Softmax 其他输入的影响。
共同平移不改变相对旋转
取 q=k=(1,0)、θ=π/6,令 Query 位于 m=1、Key 位于 n=3。两者分别旋转 30∘ 与 90∘,点积为:
(R(30∘)q)⊤(R(90∘)k)=cos(90∘−30∘)=0.5
若两个位置同时增加 10,得到 m=11,n=13,其角度差仍为 60∘,点积仍为 0.5。这说明在内容向量固定且相对位移不变时,RoPE 的点积具有共同平移不变性。
注意力点积中内容与位置的耦合
设 q=(a,b)⊤、k=(c,d)⊤,并定义 Δ=(n−m)θ,则:
q⊤R(Δ)k=(ac+bd)cosΔ+(bc−ad)sinΔ
其中,ac+bd 为未经旋转时的内容点积,bc−ad 为与向量方向相关的另一项内容组合。这两项分别由相对位置对应的 cosΔ 和 sinΔ 调制。因此,RoPE 并非直接添加独立的距离惩罚项,而是使内容匹配与相对位置发生耦合。
从二维到高维:二维子空间与旋转频率
Attention Head 内的多个二维旋转平面
当旋转维度 d=8 时,向量可以划分为以下四组:
可以分成四个二维组:
(q0,q1), (q2,q3), (q4,q5), (q6,q7)
相应的高维旋转可表示为块对角矩阵:
Rmd=diag(R(mθ0),R(mθ1),…,R(mθd/2−1))
因此:
qm=Rmdqm,kn=Rndkn
由于每个二维旋转块均满足前述代数性质,整体旋转矩阵也满足:
(Rmd)⊤Rnd=Rn−md
旋转频率的确定方式
标准 RoPE 的旋转频率定义为:
θj=B−2j/d,j=0,1,…,d/2−1
这里:
- d:进行 RoPE 旋转的维度(不一定等于整个模型的隐藏维度);
- j:二维特征组编号;
- B:频率基数(base),经典选择 B=10000,具体模型可以使用其他设置;
- mθj:位置 m 时第 j 组的实际旋转角度(弧度)。
在标准 RoPE 中,频率通常直接由上述公式计算,不需要针对每个位置学习独立参数。
当 d=8,B=10000 时:
| j | θj(弧度/Token) | 旋转一周所需位置增量 2π/θj(约) |
|---|
| 0 | 1 | 6.28 |
| 1 | 0.1 | 62.8 |
| 2 | 0.01 | 628 |
| 3 | 0.001 | 6283 |
相邻两组频率的比值为常数:
θjθj+1=B−2/d
因此,标准 RoPE 采用几何级数分布的频率,使有限数量的二维子空间覆盖多个不同的位置变化尺度。
多频率设计的作用
如果所有二维子空间采用相同频率,各组具有相同的旋转周期,位置变化产生的旋转模式较为单一。使用多个频率后,可构成覆盖不同尺度的相位组合:
Φ(m)=(mθ0,mθ1,…,mθd/2−1)(mod2π)
例如,当 θ=(1,0.1,0.01,0.001) 且位置增量约为 2π 时,第一组近似旋转一周,其他组则分别旋转约 0.628、0.0628、0.00628 弧度。因此,单个频率的相位近似重复,并不意味着整个高维旋转模式重复。
这种设计有助于表示不同尺度的位置变化,但仍需注意以下区别:
- 位置模式的可区分性:多频率可以缓解单一频率带来的周期性混淆;
- 模型对位置的有效利用:还取决于训练分布、数值精度和上下文长度,多频率不保证任意长度下的可靠泛化;
- 高低频的作用范围:高频分量对较小位置变化更敏感,低频分量变化更缓慢。这是信号的频率特性,并不意味着相关维度被限定为只处理局部或全局语义。
复数形式:用欧拉公式理解 RoPE
二维向量 (x0,x1) 可以写为复数形式:
z=x0+ix1
根据欧拉公式:
eiϕ=cosϕ+isinϕ
因此,将二维向量旋转 ϕ 等价于复数乘法:
z′=zeiϕ
对于分别位于位置 m、n 的 Query 和 Key,设其复数形式为 q,k,则:
q=qeimθ,k=keinθ
二维实向量的点积可以表示为复数乘积的实部(q,k 是两个复数,但是实际上我们需要的是这两个复数作为二维数值向量的点积,而得到这个点积的方式就是取其复数乘积的实部):
⟨q,k⟩=Re(qk)=Re(qkei(m−n)θ)
其中,上横线表示复共轭。复数推导中出现的是 m−n,矩阵推导中出现的是 n−m;这是两种等价表达中共轭与旋转作用次序不同所致,二者给出的实数点积相同。
从复数角度看,RoPE 是由位置控制的相位旋转;旋转后的 Query、Key 相乘并取实部时,绝对相位之差对应相对位置。
复数只是二维实向量的一种等价数学表示。RoPE 的复数推导与旋转矩阵推导本质相同,最终计算的都是旋转后 Query 和 Key 的实数点积。
在 Transformer 中,RoPE 与传统加性位置编码的注入位置和运算顺序有所不同。
传统输入相加:
Token Embedding x_m ──┐
                     ├─ 逐元素相加 h_m=x_m+p_m ──> 线性投影 Q/K/V
Position Vector p_m ─┘
RoPE:
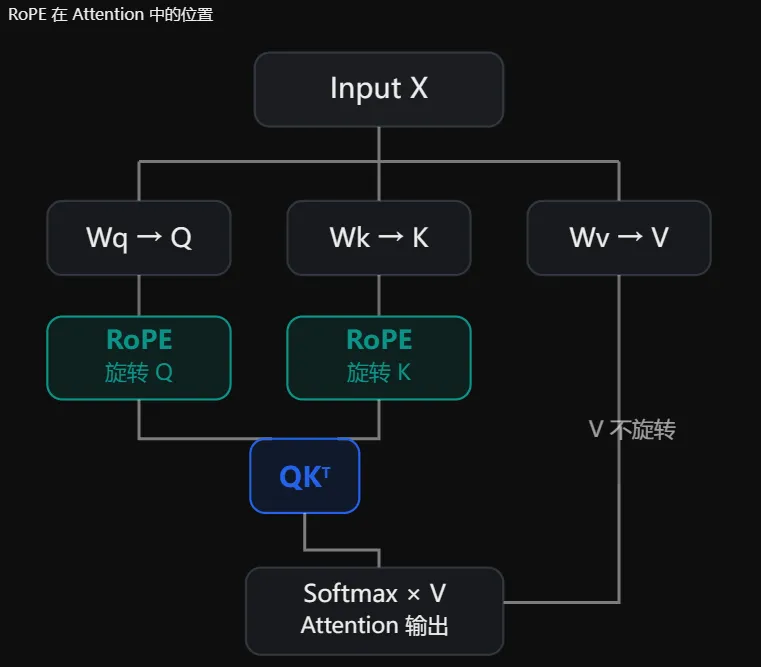
对应公式:
Q=XWQ,K=XWK,V=XWV
Q=RoPE(Q),K=RoPE(K)
Attention=Softmax(dkQK⊤+M)V
其中,M 表示因果或其他任务所需的注意力 Mask。RoPE 通常不对 Value 进行旋转,因为其目的是在 QK 匹配过程中引入相对位置关系,而非直接改变被加权聚合的内容表示。
从 1D 到 2D、3D:图像与视频中的 RoPE
文本序列的一维位置表示
文本 Token 通常使用一个离散的序列位置索引:
pos(x)=m
相比之下,图像 patch 与视频 latent patch 通常具有多维坐标:
posimage(x)=(h,w)
posvideo(x)=(t,h,w)
其中,t 表示时间索引,h 与 w 分别表示高度和宽度坐标。
多轴 RoPE 的扩展方式
一种常见的 3D-RoPE 实现思路是,将一个 Attention Head 的旋转通道分别用于时间、高度和宽度三个坐标轴。例如,当某个 Head 有 96 个旋转维度时,可以为每个轴分配 32 维(**作为示例,**具体模型不一定采用平均分配)
R(t,h,w)=diag(RT(t),RH(h),RW(w))
对于位置分别为 p1=(t1,h1,w1)、p2=(t2,h2,w2) 的两个 Token,由各坐标轴上的旋转性质可得:
(R(p1)q)⊤(R(p2)k)=q⊤R(p2−p1)k
其中:
p2−p1=(t2−t1, h2−h1, w2−w1)
由此,视频 Transformer 可以利用旋转后的注意力分数表征:
- 两个 patch 的相对时间位置;
- 二者在高度方向的相对位移;
- 二者在宽度方向的相对位移。
这是从 1D-RoPE 向 2D/3D-RoPE 的自然推广。不过,不同图像和视频模型在通道分配、坐标定义及频率设置上可能存在差异。
-
具体示例解释
一、先回顾 1D-RoPE 的旋转矩阵
对于文本,Token 只有一个位置坐标:
m=0,1,2,…,L−1
如果只有两个特征维度:
q=[q0q1]
那么对应的旋转矩阵为:
R(mθ)=[cos(mθ)sin(mθ)−sin(mθ)cos(mθ)]
但如果某个 Attention Head 有 6 个维度:
q=[q0,q1,q2,q3,q4,q5]⊤
那么它会分成三组:
(q0,q1),(q2,q3),(q4,q5)
每组使用不同的旋转频率:
R1D(m)=R(mθ0)000R(mθ1)000R(mθ2)
这里的整体旋转矩阵实际上是一个 6×6 的矩阵,由三个 2×2 旋转矩阵构成。
所以,1D-RoPE 并不意味着整个 Head 只使用一个二维旋转矩阵,而是所有二维分组都使用同一个位置坐标 m,但具有不同频率。
二、3D-RoPE 有什么不同?
对于视频,一个 Token 具有三个位置坐标:
p=(t,h,w)
分别表示:
- t:时间坐标。
- h:高度坐标。
- w:宽度坐标。
3D-RoPE 的一种常见实现是:把 Attention Head 的特征维度分成三部分,每部分只使用对应的一个位置坐标进行二维旋转。
还是以 6 维 Head 为例:
q=[q0,q1,q2,q3,q4,q5]⊤
现在将它分为:
3D-RoPE:6 维特征分配给三个坐标轴
| Time (t) | Height (h) | Width (w) |
|---|
| q0, q1 | q2, q3 | q4, q5 |
| 按 t 旋转 | 按 h 旋转 | 按 w 旋转 |
每一组仍是两个标量构成的二维特征空间。三个位置坐标只是决定不同组使用哪个旋转角度。
这样就得到:
R(t,h,w)=R(tθT)000R(hθH)000R(wθW)
其中:
R(tθT)=[cos(tθT)sin(tθT)−sin(tθT)cos(tθT)]
而 R(hθH)、R(wθW) 采用相同的二维旋转形式,只是换成对应坐标与频率。
所以,这个 3D-RoPE 旋转矩阵仍然是一个 6×6 的块对角矩阵。
与前面的 1D-RoPE 对比:
1D-RoPEdiag(R(mθ0),R(mθ1),R(mθ2))
3D-RoPEdiag(R(tθT),R(hθH),R(wθW))
两者的主要区别不是旋转矩阵的维数,而是各二维特征组使用的位置坐标不同。
视频任务中时间位置编码的作用
同一场景中的人物或物体可能出现在不同帧以及不同空间位置。Attention 除了匹配内容特征,还需要利用时间顺序与时间间隔来建模动态关系。时间轴的相对位置编码提供时间位移线索,高度轴与宽度轴的编码提供空间位移线索;具体的运动理解仍依赖内容表示与模型训练。
RoPE 性质与总结
相对位置性质
这是最核心的性质:(Rmq)⊤(Rnk)=q⊤Rn−mk
绝对位置通过旋转进入 Q、K,而注意力点积中的位置因素只依赖相对位移。
旋转不改变向量长度
旋转矩阵是正交矩阵:Rm⊤Rm=I,因此:∥Rmx∥2=∥x∥2
RoPE 不会仅仅因为位置增大,就让 Q、K 的向量范数发生变化。
这使位置编码不必通过改变向量大小来发挥作用。
不需要额外的可学习位置参数
标准 RoPE 使用由位置和频率决定的 sin、cos 运算。其位置变换本身不需要训练新的参数。
当然,模型仍然需要通过训练学习如何利用经过旋转的 Q、K。
计算开销较低
RoPE 可以直接通过逐元素乘法和加法实现。每个 Token 的额外旋转运算大致与注意力头维度成线性关系,且 sin、cos 值通常可以提前计算或缓存。
无需为每对 Token 显式引入一张额外的 N×N 可学习位置偏置表。
RoPE 不保证注意力随距离单调下降
这是一个经常被误解的地方。
如果:q=k=[10]
那么 RoPE 后的点积就是:sm,n=cos((n−m)θ)
余弦函数是周期性的,因此注意力分数可能随距离增加而上升或下降。
所以:
- RoPE 提供了感知相对距离的机制。
- 它并不直接强制模型更关注邻近 Token。
- 最终距离偏好取决于不同频率的组合、内容向量和模型训练。
原论文分析了随距离增加的某些衰减特性,但不应理解成任意两个 Token 的注意力分数都随距离严格单调递减。
总结
RoPE 把一个 Attention Head 内的 Query/Key 特征维度划分成多个二维旋转平面,用 Token 的位置和不同的预设频率决定旋转角;两个旋转后向量做点积时,绝对旋转角相减,留下只依赖相对位移的旋转关系。
附录
RoPE 与长上下文:为什么需要 RoPE Scaling?
这是现代 LLM 中非常重要的一个问题。
假设某模型主要在 4K Token 的上下文长度上训练。
那么推理时直接将它扩展到 32K,甚至 128K,能否正常工作?
未必。
虽然 RoPE 可以计算任意位置的旋转角度,但这不意味着模型已经学会处理任意长的位置范围。
为什么会出现长文本外推问题?
考虑角度:
ϕm,j=mθj
当位置 m 远大于训练时出现的范围时,模型将面临训练过程中没有充分覆盖的位置关系和相位组合。
另一方面,旋转信号具有周期性:
cos(ϕ+2π)=cosϕ
这意味着某个频率下的相位会周期性重复。
单个维度不能无限地区分位置,多频率组合虽然可以缓解这一问题,但并不自动保证任意长度的泛化能力。
常见的长上下文扩展方法
| 方法 | 核心思想 |
|---|
| Position Interpolation (PI) | 将更长的位置范围压缩映射到原有范围 |
| NTK-aware Scaling | 调整 RoPE 的频率基数或频率分布 |
| YaRN | 根据不同频率采用更细致的缩放策略,并调整注意力缩放 |
| LongRoPE | 通过更灵活的频率缩放配置扩展上下文 |
这些方法也出现在 Hugging Face 的 RoPE 配置与实现中。
-
Position Interpolation 如何工作?
假设原本支持的上下文长度为:
L=4096
希望扩展至:
L′=32768
那么扩展比例:
s=LL′=8
最简单的位置插值是:
m′=sm
原本的旋转角度:
ϕm,j=mθj
改为:
ϕm,j′=smθj
这就相当于把旋转速度放慢 8 倍。
但这种做法也有代价:原来相邻两个位置的旋转角度差是 θj,缩放后变成:
8θj
局部位置的角度区分度因此发生变化。
这也是为什么后来出现 NTK-aware、YaRN 等方法,希望在保留局部位置分辨能力和扩展远距离表示之间取得更好的平衡。
仅修改 RoPE 参数并不能保证长上下文效果。实际性能还取决于模型训练、长上下文微调、注意力架构以及任务类型。
RoPE 与 KV Cache 的关系
在自回归推理时,模型会逐个生成 Token。
如果每生成一个 Token 都重新计算之前所有 Token 的 K 和 V,计算开销会很大。
KV Cache 的做法是缓存历史的 Key 和 Value。
对于使用 RoPE 的模型:
k~n=Rnkn
历史 Key 可以在旋转之后直接保存。
当生成新 Token,位置为 m 时:
q~m=Rmqm
接着使用新 Query 与历史缓存的 Key 计算注意力:
q~m⊤k~n=qm⊤Rn−mkn
所以,不需要因为位置差发生变化,就重新旋转所有历史 Key。
这使 RoPE 与 KV Cache 非常容易结合。
不过,实现时有一个关键细节:必须使用正确的全局位置索引。
例如 Prompt 已经包含 100 个 Token,那么下一个生成 Token 的位置通常是 100(采用从 0 开始的索引),而不是重新从 0 开始。
否则,Query 和缓存 Key 之间的相对位置关系就会出错。
参考资料:
- RoFormer: Enhanced Transformer with Rotary Position Embedding —— RoPE 原始论文。
- Attention Is All You Need —— 经典 Transformer 与固定正弦位置编码。
- Self-Attention with Relative Position Representations —— 早期相对位置注意力。
- PyTorch / Torch-TensorRT: 3D Rotary Position Embedding —— 视频多轴 RoPE 的实现示例。